問い合わせCSVを丸ごとJSONにしたら、不要な3列が3行とも残った。合成データでAIへ渡す列を2列に絞る
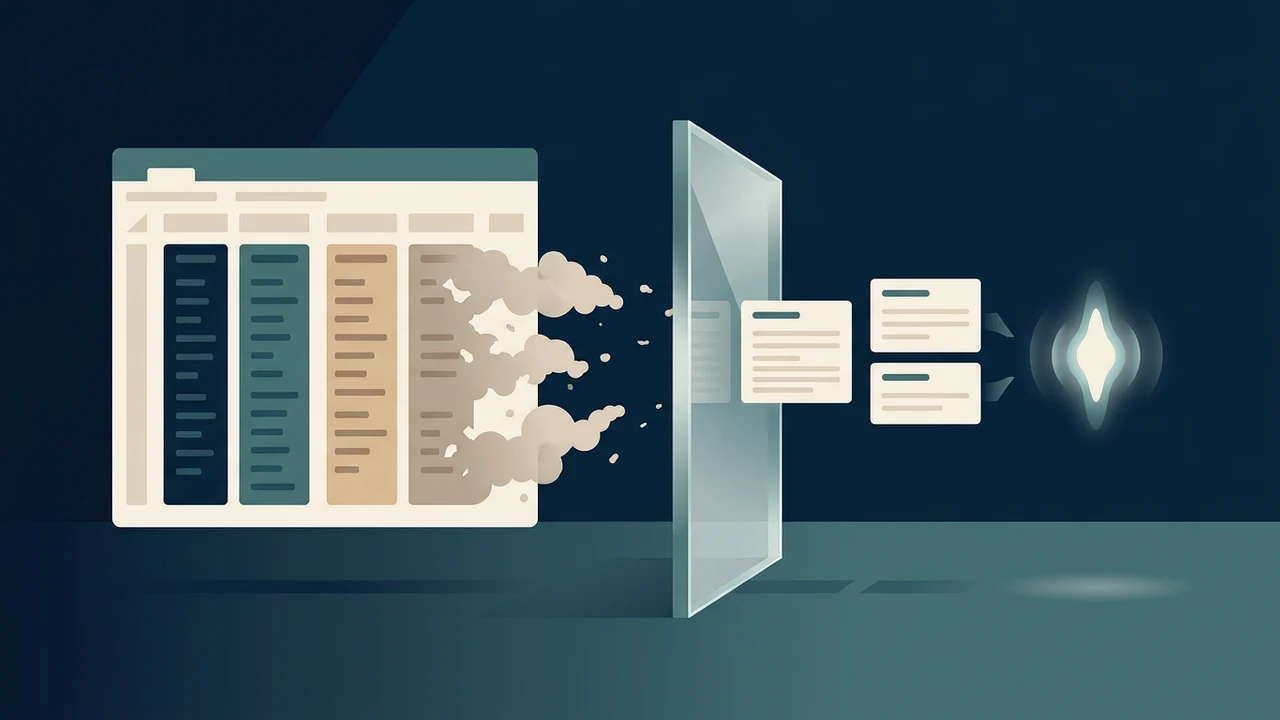
購入者からの質問をAIへ渡すとき、CSV(列名と値をカンマで区切って並べる表形式のテキスト)の1行をそのままJSONへ変換すると何が起きるか。検査用に作った3行で確かめると、返答に不要な3列(注文番号、メールアドレス、社内メモ)が3行すべてに残りました。
ここで扱うCSVは、献立テンプレートと見積もりテンプレートを売る場面を想定した検査用データです。実在する購入者、注文、販売実績は使っていません。それでも、入力を丸ごと渡す書き方の問題は確認できました。
前回は、購入者対応AIのルールと商品説明を分けた試行を作りました。今回は、そのAIに届く手前のCSVを小さくする話です。ルールを分けても、入力が広すぎれば意味がありません。
返答に必要なのは、注文台帳の全列ではない
必要なのは、商品の種類と質問文です。注文番号、メールアドレス、対応メモまで、回答文を作るたびに渡す理由はありません。
CSVは列名を先頭行に持てます。RFC 4180も、そのヘッダーを各レコードのフィールド名として扱う形式を説明しています。AIへ渡す前に、使う列を選びます。入力の境界はここ。
| 列 | この検査での扱い | 理由 |
|---|---|---|
product | 渡す | 商品ごとに案内を変えるため |
question | 渡す | 回答の対象そのものだから |
order_id | 渡さない | この検査の回答生成には不要だから |
email | 渡さない | この検査の回答生成には不要だから |
note | 渡さない | 対応履歴を含み得るため |
AIリスクの管理は、モデルを選ぶ場面だけではありません。NISTのAI RMFは、AI製品やサービスの設計、利用、評価へ信頼性を組み込むための枠組みです。個人で小さく始めるときも、入力を点検できる形にする方が後で直しやすいと私は考えます。
3行を丸ごと変換すると、不要な3列が3行とも残った
一時ディレクトリで、まず検査用CSVを作ります。example.testは予約済みのテスト用ドメインです。
mkdir -p "$TMPDIR/hibanas-csv-minimization-sample"
cd "$TMPDIR/hibanas-csv-minimization-sample"
cat > inquiries.csv <<'CSV'
order_id,email,product,question,note
ord-1042,[email protected],献立テンプレート,PDFはスマホで開けますか,初回問い合わせ
ord-1043,[email protected],献立テンプレート,ダウンロードリンクをもう一度もらえますか,再送希望
ord-1044,[email protected],見積もりテンプレート,Excel以外で使えますか,購入前の質問
CSV出力はありません。inquiries.csvを作成します。
最初はDictReaderが返す1行全体をJSONにしました。失敗の出発点。その後で、productとquestionだけを選ぶ処理を足しました。禁止列(AIへ渡さないと決めた列)の名前が出た回数も数えます。
cat > check.py <<'PY'
import csv
import json
from pathlib import Path

root = Path(__file__).parent
rows = list(csv.DictReader((root / "inquiries.csv").open(encoding="utf-8")))
forbidden = {"order_id", "email", "note"}

bad = [json.dumps(row, ensure_ascii=False) for row in rows]
safe = [json.dumps({"product": row["product"], "question": row["question"]}, ensure_ascii=False) for row in rows]
(root / "bad.jsonl").write_text("\n".join(bad) + "\n", encoding="utf-8")
(root / "prompt-input.jsonl").write_text("\n".join(safe) + "\n", encoding="utf-8")

for label, lines in (("bad", bad), ("fixed", safe)):
    hits = sum(field in line for line in lines for field in forbidden)
    print(f"{label}: rows={len(lines)} forbidden-field-hits={hits}")
print((root / "prompt-input.jsonl").read_text(encoding="utf-8"), end="")
PY出力はありません。check.pyを作成します。次に実行します。
python3 check.py実行結果は次のとおりでした。
bad: rows=3 forbidden-field-hits=9
fixed: rows=3 forbidden-field-hits=0
{"product": "献立テンプレート", "question": "PDFはスマホで開けますか"}
{"product": "献立テンプレート", "question": "ダウンロードリンクをもう一度もらえますか"}
{"product": "見積もりテンプレート", "question": "Excel以外で使えますか"}9は、3行それぞれにorder_id、email、noteが残った回数です。重複を除いたデータの種類が9個という意味ではありません。最初の変換は、質問への回答に不要な3列まで持ち出していました。
処理の流れはこうなります。
inquiries.csv
  ├─ order_id, email, note ── 渡さない
└─ product, question ── check.py ── prompt-input.jsonl ── AIへの入力prompt-input.jsonlには、商品名と質問だけが残ります。JSONLはJSONオブジェクトを1行ずつ置く形式です。問い合わせを1件ずつ処理したいとき、行単位で読めます。
列を落としても、質問文そのものは残る
この検査で防げるのは、名前が分かっている列の混入だけです。questionの中にメールアドレスや住所が書かれていれば、列を選んだだけでは消えません。ここは最初の見立てと違いました。列の選択だけで入力が安全になると思うと、本文の中身を見落とします。
OWASPのLLM向けリスク一覧は、機密情報の漏えいを扱っています。個人事業の小さな自動化でも、入力を減らす処理と、質問文に含まれる情報をどう扱うかは別に決める必要があります。
私なら、始め方はこの順です。
- まず合成データ(実在する購入者や注文を含めず検査のために作ったデータ)で、AIへ渡す列を2〜3個に固定する
forbidden-field-hits=0を、送信前の条件にする- 実データを使う前に、質問文に残す情報と伏せる情報を商品ごとに書き出す
最初に確かめるのは、回答の質より先に、AIへ渡す入力の範囲です。購入者対応を広げるほど、手前で列を選んでおく意味が大きくなります。
参照した一次情報