ZIPを展開する場所で、案内ファイルが1つ消える。名前の衝突を先に検査する
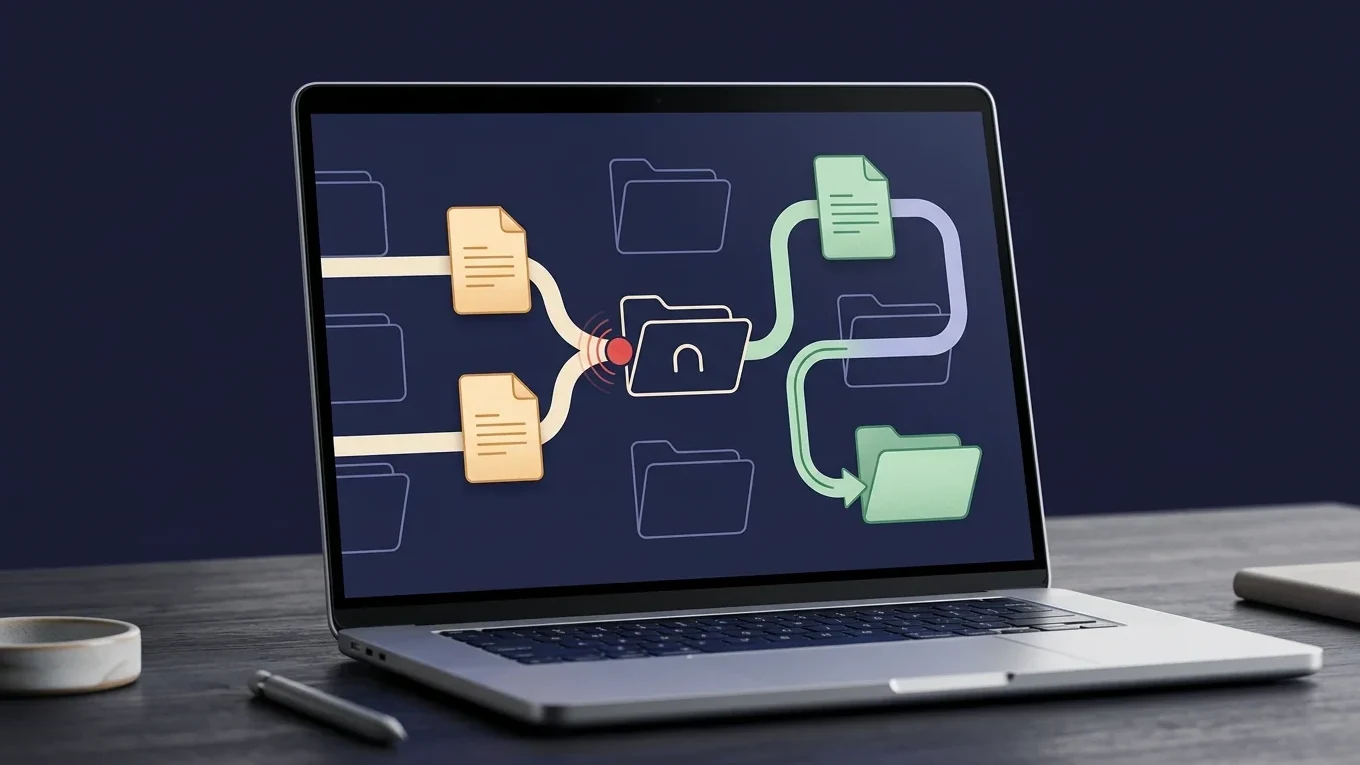
Guide.mdとguide.mdを同じZIPへ入れる操作は、Pythonでは止まりませんでした。作成元では2ファイルとして一覧に出ます。でも、展開先が名前の大文字小文字を区別しない運用なら、購入者が読む案内は片方だけになる恐れがあります。
AIに商品説明、ワークシート、利用案内をまとめて作らせると、ファイル名も一緒に増えます。中身の文章を読むだけでは、名前同士の衝突まで見つかりません。そこで実際の販売物ではなく、小さな合成ZIPを3つ作り、展開前に止める検査を試しました。
前に日本語名の文字化けと正規化を確かめたときは、1つの名前を正しく読めるかが中心でした。今回は別です。ZIP内で別々に見える名前が、展開先では同じ名前として扱われる組を探します。
ZIPが作れたことを、納品可能とはしない
Pythonのzipfileは、ZIPの作成、読取り、一覧取得を扱えます。まずGuide.mdとguide.mdを含むfirst-try.zip、日本語の濁点を別の並びで持つunicode-collision.zip、名前を整理したfixed.zipを用意しました。
この見本の目的は、特定のOSでどちらが残るかを再現することではありません。展開先の規則が異なる前に、購入者へ渡す候補から曖昧な名前を外すことです。AIが生成した実物を使った実験ではありません。
from __future__ import annotations

import unicodedata
import zipfile
from pathlib import Path

root = Path(".")


def write(name: str, members: list[str]) -> None:
    with zipfile.ZipFile(root / name, "w", zipfile.ZIP_DEFLATED) as archive:
        for member in members:
            archive.writestr(member, f"# {member}\n")


write("first-try.zip", ["Guide.md", "guide.md"])
write(
    "unicode-collision.zip",
    ["素材/ガイド.txt", "素材/" + unicodedata.normalize("NFD", "ガイド") + ".txt"],
)
write("fixed.zip", ["guide.md", "素材/ガイド.txt"])
私は最初、ZIPの作成が完了すれば、同じ場所へ展開される名前も止められていると思いかけました。しかし、ZIPは複数のメンバー名を持てます。作成の成功と、配布先で区別できる名前であることは別の条件です。
比較用の名前を1つに寄せる
検査では、各パスをスラッシュ単位に分けます。各部分をNFCへそろえ、casefold()で比較用の形に変えてから再結合しました。casefold()は単純な小文字化より広く、大文字小文字を区別しない比較を目的にした文字列メソッドです。
Unicode正規化は、同じ文字として扱いたい複数の表現を1つのバイト列へ寄せる考え方です。ここではNFCを使います。正規化や大文字小文字を変えた後の名前が一致したら、元の名前を並べて失敗にします。
from __future__ import annotations

import sys
import unicodedata
import zipfile
from collections import defaultdict
from pathlib import PurePosixPath


def key(name: str) -> str:
    parts = PurePosixPath(name).parts
    return "/".join(unicodedata.normalize("NFC", part).casefold() for part in parts)


def check(path: str) -> list[str]:
    groups: dict[str, list[str]] = defaultdict(list)
    with zipfile.ZipFile(path) as archive:
        for info in archive.infolist():
            if info.is_dir():
                continue
            groups[key(info.filename)].append(info.filename)
    return [f"COLLISION {' | '.join(names)}" for names in groups.values() if len(names) > 1]


failed = False
for path in sys.argv[1:]:
    collisions = check(path)
    state = "FAIL" if collisions else "PASS"
    print(f"{PurePosixPath(path).name}: {state} collisions={len(collisions)}")
    for collision in collisions:
        print(f"  {collision}")
    failed |= bool(collisions)
raise SystemExit(1 if failed else 0)このコードを$TMPDIR/zip-casefold-lab/check_zip_name_collisions.pyとして保存しました。$TMPDIRは、その場で消してよい一時ディレクトリです。検査対象のZIPを作ってから、同じ順番で渡します。
cd "$TMPDIR/zip-casefold-lab"
python3 --version
python3 make_samples.py
python3 check_zip_name_collisions.py first-try.zip unicode-collision.zip fixed.zip
status=$?
printf 'exit=%s\n' "$status"
Python 3.13.5
first-try.zip: FAIL collisions=1
COLLISION Guide.md | guide.md
unicode-collision.zip: FAIL collisions=1
COLLISION 素材/ガイド.txt | 素材/ガイド.txt
fixed.zip: PASS collisions=0
exit=1first-try.zipは英字の大文字小文字だけが違います。unicode-collision.zipの2行も端末ではほぼ同じに見えますが、後ろの名前は濁点を別の文字として持っています。どちらも、NFCとcasefold()を通すと同じ比較用の名前になりました。
fixed.zipだけは衝突0件です。ただし、このPASSは「どの環境でも安全に展開できる」と保証するものではありません。予約語、禁止文字、パス長、圧縮ファイルの安全性は別の確認が必要です。
直す場所は検査の後ではなく、生成の規則です
衝突を見つけたあと、検査器が片方を勝手に改名する方法もあります。私は配布物でそれをしません。READMEや本文のリンクが古い名前のまま残ると、別の不具合を作るからです。
代わりに、AIへ渡す商品用の命名規則を短く固定します。英字は小文字に寄せます。1つのフォルダ内で同じ意味の案内を複数作りません。日本語名は作成時にNFCへそろえます。生成後は、ZIPへ入れる直前にこの検査をします。
ここで迷ったのは、lower()だけで足りるかでした。英字だけの配布物なら目立たない差です。それでも、商品名や案内文が別の言語を含むなら、比較規則を最初からcasefold()へ寄せた方が、検査の意図を説明しやすいと判断しました。
AIでファイルを増やす速さは、名前の一意性を保証しません。購入者が開く前に、ZIPの一覧を比較用の名前へ変換して重なりを出します。小さい検査ですが、消えた案内ファイルを問い合わせで知るより先に止められます。
出典
- Python公式文書: zipfile(ZIPアーカイブの作成、読取り、メンバー一覧)
- Python公式文書: unicodedata(Unicodeの正規化)
- Python公式文書: str.casefold(大文字小文字を区別しない比較向けの変換)
- Unicode Standard Annex #15: Unicode Normalization Forms(Unicode正規化の定義)