Hermes Agentのcronをつなぐ|context_fromで前の結果を安全に引き継ぐ
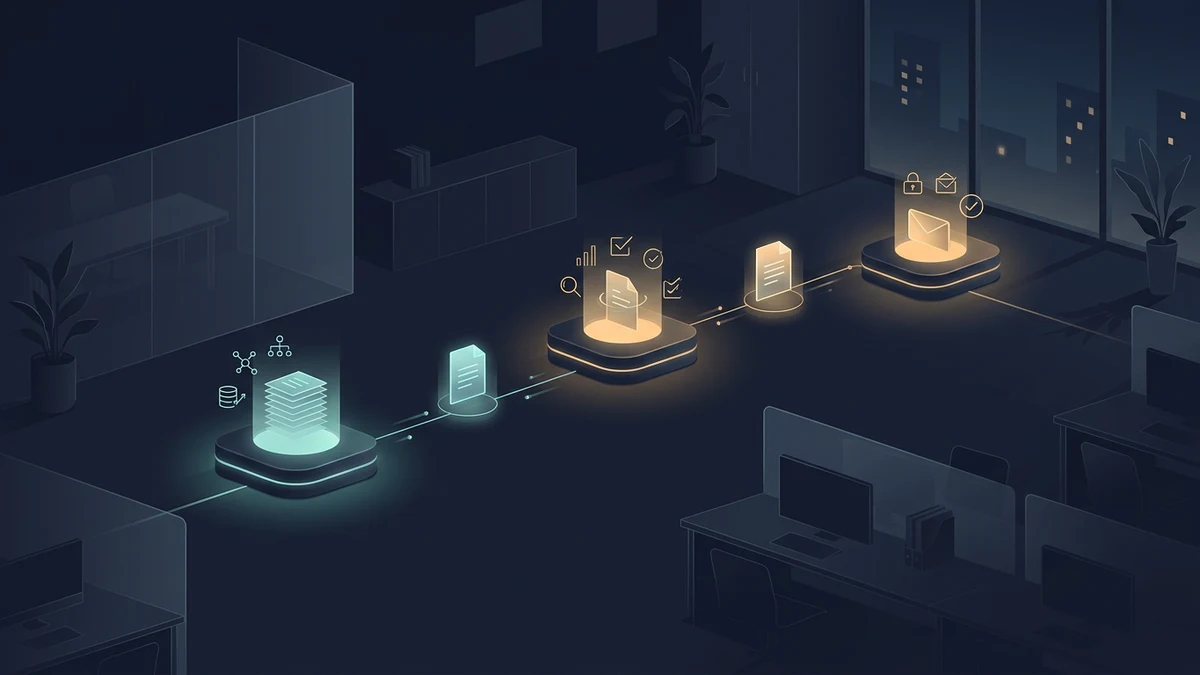
朝に集めた候補を、昼の判定処理へ渡したいことがあります。けれども、定期ジョブは原則として毎回まっさらなセッションで起動します。前の処理が何を見つけたかは、次の処理には残りません。
Hermes Agent のcontext_fromは、この切れ目を意図してつなぐための指定です。収集、絞り込み、配信を 1 つの長いプロンプトへ詰め込まず、仕事ごとに分けたまま直前の結果を渡せます。ただし、便利だからと出力を丸ごと流すと、古い情報、失敗メッセージ、秘密まで次の仕事の入力になり得ます。受け渡しの境界を決めてから使う方が安全です。
前回完了時から今回完了後まで
前回の「Hermes Agentのcronでscriptのデータを検査する」では、モデルへ渡す前のデータを検査する位置を整理しました。今回は、複数の cron job の間で結果を渡す位置を扱います。
| 時点 | 状態 |
|---|---|
| 前回完了時 | 1本のjobへ入るデータを検査できます |
| 今回開始時 | jobを分けると、前段の結果を次段が自動では知りません |
| 今回完了後 | context_fromで必要な出力だけを次段へ渡し、失敗時の確認場所も分けられます |
単発の通知だけを送りたい場合は、この章を飛ばして構いません。前段の出力を次段の判断材料にしたい時だけ、連鎖を作ります。
なぜ1本の長いjobにしないのか
収集、判断、配信を 1 つの job にすると、失敗した場所を追いにくくなります。たとえばニュース収集で外部サイトが一時的に読めなかった時、配信の失敗なのか収集の失敗なのかが、最終メッセージだけでは曖昧になります。
仕事を分けると、前段は「候補を集める」だけに集中できます。後段は、渡された候補から必要なものだけを選べます。配信 job は、選ばれた内容を整える仕事だけを持ちます。
Hermes Agent の cron は、期限を迎えると新しいAIAgentセッションを開始します。そのため、job を分けただけでは文脈を共有できません。context_fromは、前段 job の最新出力を後段の prompt 先頭へ付ける仕組みです。独立性を保ちながら、必要な受け渡しだけを明示できます。
用語をそろえる
| 用語 | この回での意味 |
|---|---|
| 前段job | 情報の収集や整形を担当し、結果を出すcron jobです |
| 後段job | 前段の結果を読み、判定や配信を担当するcron jobです |
context_from | 後段jobへ、指定したjobの最新出力を追加する指定です |
| context | モデルが処理前に読む入力です。長くするほど判断材料とtoken使用量が増えます |
continuity | 同じjob自身の前回出力を、次回の入力へ渡す指定です |
| run document | 実行ごとにcron出力ディレクトリへ残る記録です |
受け渡しは一本の矢印として設計する
最初は、収集から判定への一本だけで十分です。複数の経路を最初からつなぐと、どの出力が判断を変えたか追いにくくなります。
[収集job]
  公開情報を集め、候補を短いMarkdownで出す
        │
        │ 最新の出力だけ
        ▼
[判定job]
  候補を基準で絞り、採用理由と除外理由を出す
        │
        │ 採用済みの短い結果だけ
        ▼
[配信job]
  配信用の文面に整え、指定先へ送る
後段 job へcontext_fromとして前段 job の ID を設定すると、実行時に前段の最新出力が読み込まれ、後段の prompt 前へ追加されます。複数の job ID も指定でき、その場合は指定した順番で出力が連結されます。
ここで重要なのは、前段の出力を次段の「正しい事実」と見なさないことです。前段が URL や時刻を取り違えれば、その誤りも渡ります。後段の prompt には、受け取った内容を採用する前に、元の公開 URL や必要なデータを確認する条件を書きます。
前段の出力を小さく、用途別にする
context_fromが渡すのは、前段の最新出力です。長い調査ログや会話調の報告をそのまま残すと、後段は判断に不要な文章まで読みます。前段 job は、次段が必要とする項目だけを短く出すようにします。
ニュースを選ぶなら、タイトル、公開 URL、公開日時、短い根拠で足ります。後段が必要としない生の HTML、HTTP header、認証情報、環境変数、ローカルパスは出力へ入れません。出力ファイルが private でも、次のモデル入力になる可能性があるためです。
私は前段 job の prompt へ、次のような境界を入れます。
公開URL、題名、日時、100字以内の要点だけをMarkdownで出力する。
トークン、cookie、環境変数、認証付きURL、内部パス、全文ログは出力しない。
候補がない場合は「候補なし」と1行だけ出力する。
この形なら、後段 job の入力量を予測しやすくなります。空振りの日も、前段の報告が長文化しません。
job IDと直近の実行を確認する
context_fromを設定する前に、前段 job が存在し、実行履歴を読めることを確認します。次のコマンドは現在の cron 一覧を読むだけで、job を変更しません。
hermes cron list期待する表示には、前段として使う job の ID、名前、次回実行時刻、直近の状態が含まれます。実際の列名や表示は導入版で変わるため、設定に使う ID はこの出力からそのままコピーします。
続けて、対象 job の最近の記録を確認します。
hermes cron runs <cron listで確認したjob ID> --limit 5<cron listで確認したjob ID>は文字どおり実在する ID へ置き換えます。期待する状態は、直近の実行がcompletedで、後段へ渡したくないエラー文や機密らしい文字列が出力にないことです。これは仕様から導いた確認観点であり、ここに示した状態はこのサイトの実行結果ではありません。
失敗時の run は、回復用のエラー文書を残す場合があります。Hermes の公式仕様では、continuityでもエラー文書は次回 context の候補になります。したがって、失敗を無条件に「前回の正常な結果」として引き継がない設計が必要です。
continuityとは別の仕事です
前段 job の前回結果を自分自身へ渡したい場合は、continuity=trueを使います。これは、前の発見を見ながら重複を避ける監視 job に向いています。
[監視jobの前回出力]
        │
        ▼
[同じ監視jobの次回実行]
  すでに報告した項目を避けて、新しい項目だけを出す
一方、収集 job の結果を別の判定 job へ渡すのがcontext_fromです。両方を組み合わせることもできますが、最初は目的を混ぜない方が保守しやすくなります。自分の重複回避にはcontinuity、別 job への受け渡しにはcontext_fromと分けます。
失敗時は出力、実行履歴、配信を分けて見る
cron の失敗には、モデル処理、scheduler から worker への起動、配信の 3 つがあります。後段 job が動かなかった時に、前段の情報が悪いと決めつけないことが大切です。
| 症状 | 先に見る場所 | 分けて考える理由 |
|---|---|---|
| 前段jobの結果が古い | hermes cron runsと前段の出力 | 前段が未実行か、最新出力が期待と違う可能性があります |
| 後段jobが失敗した | 後段jobのlast_errorとrun document | 入力は渡っていても、後段のpromptやproviderが失敗する場合があります |
| 自動実行だけ動かない | last_fire_errorとhermes cron doctor | schedulerからgatewayへの受け渡しが始まっていない場合があります |
| 出力はあるのに通知が届かない | last_delivery_error | job本体とdeliveryは別の失敗経路です |
| 前段の失敗内容が後段に混ざる | 前段の最新出力とprompt | error documentもcontext候補になり得るためです |
hermes cron doctorは active な job を読み取り専用で点検します。定期的に実行しても job 設定を変えません。
hermes cron doctor期待する表示は、問題がない時は終了コード 0 です。問題がある時は、失敗した job、遅延した dispatch、存在しない workdir などを job ごとに示し、終了コード 1 になります。この説明は公式仕様に基づく期待結果です。設定や cron の状態により、実際の表示は異なります。
秘密と大きな本文を流さない
context_fromは便利な内部配線ですが、秘密の保管場所ではありません。前段 job が tool 出力に認証 URL、Cookie、個人情報、顧客データを含めると、その文字列が後段のモデル入力へ近づきます。redaction があるから安全、と決めない方がよいです。
受け渡す前に、前段の出力形式を固定します。公開 URL だけを許す、文字数を上限で切る、候補なしを 1 行にする、というように狭くします。本文全文が必要な処理では、context へ流す代わりに後段が公開 URL を改めて取得し、必要な範囲だけを読む設計にします。
複数の収集 job を 1 つの集計 job へ入れる場合も同じです。context_fromのリスト順が連結順になるため、先に短い要約、次に詳細という順序を決めます。無制限に job を足すより、集計前に各 job の出力契約をそろえる方が、入力の膨張を抑えられます。
小さな連鎖から始める
最初の目標は、三段の自動化ではありません。収集 job の最新結果を、判定 job が一度だけ正しく読めることです。前段の出力を短くし、job ID を一覧から確認し、後段の結果を実行履歴で読む。この 3 つができてから配信 job を足します。
cron をつなぐ時は、前段の成功だけで終わりにしません。何を渡すか、何を渡さないか、失敗した時にどこを読むかまで決めます。context_fromは記憶を増やす機能ではなく、必要な結果だけを明示して渡すための境界です。
一次情報
| 資料 | 確認した内容 |
|---|---|
| Scheduled Tasks (Cron) | jobごとの新規セッション、context_from、複数IDの連結順、continuity、run history、失敗状態 |
| Hermes Agent Configuration | 設定の配置、優先順位、秘密を.envへ分ける基本方針 |
| Script-Only Cron Jobs | scriptだけで実行するjobの使い分け |
| Hermes Agent | 公式ソースコードとリリース情報 |
機能や CLI の表示は導入版によって変わります。設定を変える前にhermes cron listと公式ドキュメントで、現在の job ID と利用可能な項目を確認してください。